Um alerta é um ponto de partida para investigar, não uma conclusão automática sobre o que aconteceu. A equipe precisa entender o dispositivo, o usuário, a sequência de eventos e o possível impacto antes de escolher uma ação de contenção.
Valide o contexto
Confira a gravidade, a hora, o dispositivo e os indicadores associados. Relacione o alerta a outros eventos do mesmo equipamento e verifique se há atividade semelhante em outros endpoints. Considere mudanças legítimas recentes, ferramentas administrativas e janelas de manutenção antes de classificar um comportamento como malicioso.
Registre a linha do tempo: o que ocorreu primeiro, quais processos ou arquivos aparecem e que conexões foram observadas. Preserve os dados pertinentes conforme o procedimento de resposta a incidentes da organização. Evite apagar evidências ao tentar resolver rapidamente o sintoma.
Escolha a contenção proporcional
Se houver risco ativo, avalie as ações disponíveis no produto e siga a matriz de autoridade definida pela empresa. Isolar um dispositivo, restringir uma conta ou bloquear um indicador pode reduzir a exposição, mas cada ação também pode interromper uma atividade legítima. Para sistemas críticos, combine a decisão com o responsável operacional quando o cenário permitir.
Após a contenção, confirme se o risco cessou, documente as evidências e acompanhe a recuperação. Fechar o alerta não equivale a erradicar a causa. Investigue o vetor inicial, verifique controles relacionados e identifique se outros ativos foram afetados.
Prepare antes do incidente
Defina papéis, canais de escalonamento e critérios para ações emergenciais. Exercícios ajudam a descobrir se analistas têm acesso suficiente aos dados e se a comunicação com as áreas de negócio funciona fora do horário habitual.
Em um incidente, uma hipótese registrada e revisada é mais útil do que uma conclusão apressada. Combine evidência técnica com o impacto operacional antes de escolher como conter o dispositivo.
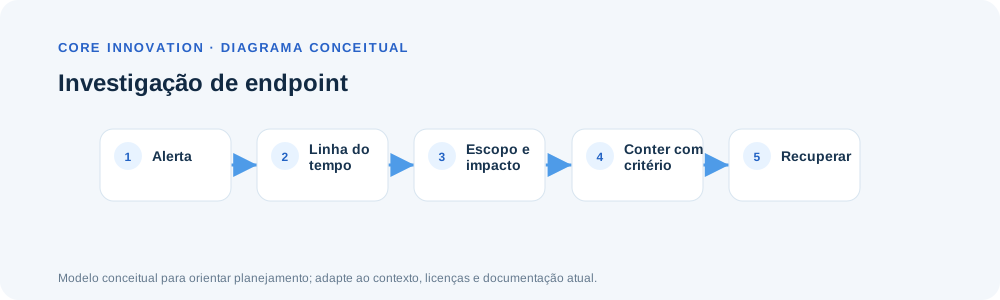
Monte uma linha do tempo, não uma história por suposição
Ao abrir um alerta, preserve o identificador, severidade, ativo e horário observado. Examine a história do alerta, processos relacionados, usuário, arquivo, conexões de rede e outros dispositivos relacionados. Compare com a linha de base da organização e com mudanças recentes autorizadas. Um processo incomum pode ser legítimo; uma cadeia de eventos correlacionada pode elevar a prioridade.
Registre fatos observados separadamente de hipóteses: “o executável iniciou às 10h” é evidência; “houve roubo de credenciais” é uma hipótese até confirmada. Anote fonte, horário e analista. Isso torna a passagem de turno mais clara e reduz conclusões que se propagam sem validação.
Contenha com critério e coordenação
Isolar um dispositivo pode reduzir comunicação de rede, mas também interromper trabalho ou operação. Antes de agir, confirme criticidade, redundância, impacto e autoridade de aprovação. Se a atividade parece estar se espalhando, siga o plano de incidentes, envolva a liderança apropriada e registre a decisão. Preserve evidências necessárias antes de reimagem ou limpeza, conforme procedimento interno.
O encerramento inclui verificar se o alerta foi classificado, se os dispositivos afetados foram identificados, se as ações aparecem concluídas e se o usuário pode retomar o trabalho com segurança. Documente medidas compensatórias e perguntas abertas; não encerre só porque o painel mudou de estado.
O fluxo visual é um roteiro conceitual, não um incidente real. As ações disponíveis dependem do plano e do estado do dispositivo. Valide permissões e procedimentos internos antes de executar contenção.